Google发布DiffusionGemma——速度与质量权衡的最快AI模型
简要回答
Google发布了实验性AI模型DiffusionGemma,通过并行处理文本块实现比传统方案快4倍的生成速度,但输出质量有所不及。
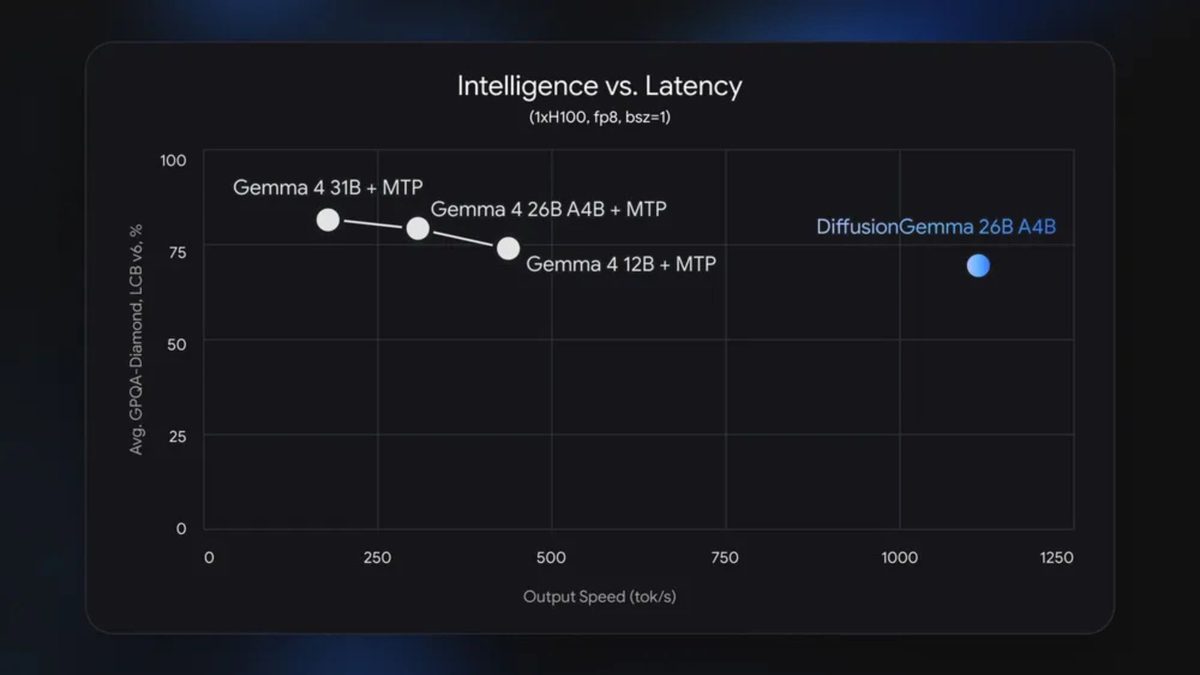
Google发布了实验性人工智能模型DiffusionGemma,为文本生成提供了全新的解决方案。与Gemma 4等传统模型逐词生成文本不同,DiffusionGemma能够一次性生成整个文本块,并通过多次迭代优化。这种方法显著提升了生成速度,但会导致最终输出质量下降。
据Google介绍,DiffusionGemma的文本生成速度可达传统自回归模型的四倍。在NVIDIA H100等高性能设备上,模型生成速度可超过每秒1000个token,而在RTX 5090*上则约为每秒700个token。这使其成为追求速度而非精确度的应用场景的理想选择,如实时交互助手等。
该模型基于260亿参数的Mixture-of-Experts架构,但实际运行时仅使用约38亿参数。这降低了对计算资源的需求,并允许在量化后使用约18GB显存的高性能消费级GPU运行。DiffusionGemma在结构化任务上表现尤为出色,如代码补全、JSON格式处理或逻辑谜题求解。
然而,新模型也存在不足。其生成文本的质量不及Gemma 4等传统方案,可能出现连贯性和准确性下降的问题,这限制了其在高精度需求场景中的应用。Google将其定位为实验性工具,适用于注重速度和即时反馈而非完美质量的应用场景。
该模型现已以Apache 2.0许可证向开发者和研究人员开放。它并非用于替代现有的Gemini或Gemma模型,而是展示了一种以速度和效率为优先的文本生成新思路。
常见问题
- DiffusionGemma与普通AI模型有何不同?
- 与逐步生成文本的传统模型不同,DiffusionGemma能够一次性生成整个文本块,并通过多次迭代优化。这种方式提升了生成速度,但会降低最终输出质量。
- DiffusionGemma在哪些任务上表现最佳?
- 该模型在结构化任务上表现优异,如代码填充、JSON处理、逻辑谜题或数学模式识别,并能在单次生成周期内修正矛盾内容。
- DiffusionGemma的硬件要求是什么?
- 该模型基于260亿参数架构,实际使用约38亿参数,在量化后需约18GB显存。适用于高性能GPU,如NVIDIA H100或RTX 5090。
分享:
Dzen 订阅: /feed/dzen.xml · RSS: /feed.xml