LLM上下文压缩新方法:输入数据减少16倍且不损失精度
简要回答
研究人员推出Latent Context Language Models(LCLM),一种将LLM输入数据压缩16倍的方法,在RULER基准测试中处理速度提升8.8倍,且精度损失极小。
纽约大学、哥伦比亚大学、普林斯顿大学、马里兰大学、哈佛大学及劳伦斯利弗莫尔国家实验室的研究团队提出了一种大语言模型(LLM)上下文压缩的新方法。该技术名为Latent Context Language Models(LCLM),可将输入数据量减少16倍,同时保持模型高精度。这解决了现代LLM面临的关键挑战——随着上下文长度增加,计算成本激增已成为性能瓶颈。
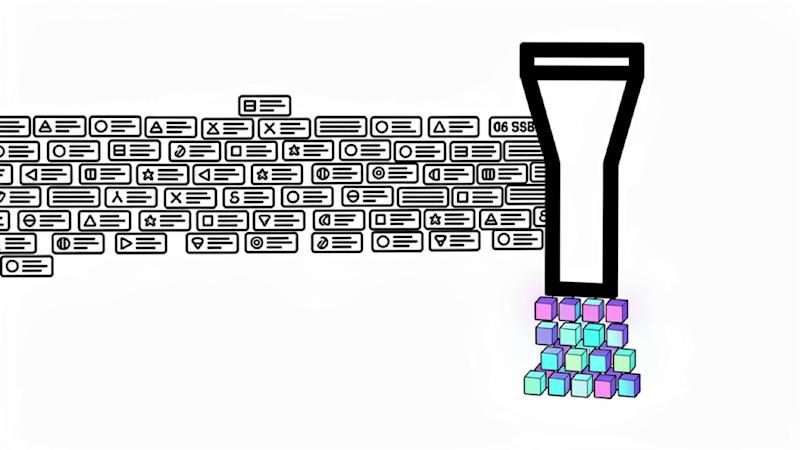
与传统KV缓存压缩方法需先加载完整数据再压缩不同,LCLM在解码器处理前即压缩输入token。这直接降低了内存与计算资源需求。在RULER基准测试中,16倍压缩模型处理速度较基准方法提升8.8倍。精度损失极小:未压缩时为94.41%,删除93.75%输入token后降至75.06%。
LCLM架构包含0.6B参数编码器与4B参数解码器。编码器将输入token块转换为更短的潜在嵌入序列,再由解码器处理。训练使用超过3500亿token,涵盖连续预训练、微调数据及辅助重建任务,在数据恢复精度与整体性能间取得平衡。
开发者强调,LCLM可轻松集成现有系统,通过模型压缩器预处理输入数据即可替代标准LLM。但在代理系统中需调整RAG流程并测试实际负载下的模型行为。源代码与模型已在HuggingFace与GitHub发布。
对于使用LLM的企业,新方法显著降低推理成本。处理100万token上下文时,传统KV缓存压缩方法需超出H200 GPU能力的资源,而LCLM在如此规模下仍保持功能,成为基础设施扩展的理想解决方案。
常见问题
- 什么是Latent Context Language Models(LCLM)?
- LCLM是一种大语言模型上下文压缩技术,在解码器处理前压缩输入数据,在不显著损失精度的情况下降低内存与计算负载。
- 16倍上下文压缩有哪些优势?
- 在16倍压缩下,LCLM处理速度较传统KV缓存压缩方法提升8.8倍,降低计算成本并支持处理更长上下文而不影响性能。
- LCLM能否集成到现有系统?
- 可以。LCLM设计为易于集成,可通过模型压缩器预处理输入数据,直接替代标准LLM。
Dzen 订阅: /feed/dzen.xml · RSS: /feed.xml